1. Фреймворк для мультитенантных приложений
В основе Clodex лежит собственный фреймворк. Каждая компания хранит данные в отдельной схеме базы данных — это даёт строгую изоляцию на уровне СУБД, а не только на уровне кода приложения. Миграции применяются ко всем пространствам автоматически.
Главная часть фреймворка — движок моделей. Разработчик один раз описывает модель: поля, связи, права, поиск и фильтры. Всё остальное — хранение, API, проверка прав, журнал аудита и события для автоматизаций — движок строит сам. Благодаря этому новые модули (проекты, задачи, контакты, товары и счета) появляются в разы быстрее, а поведение у них единообразное.
2. Задачи и канбан-доски
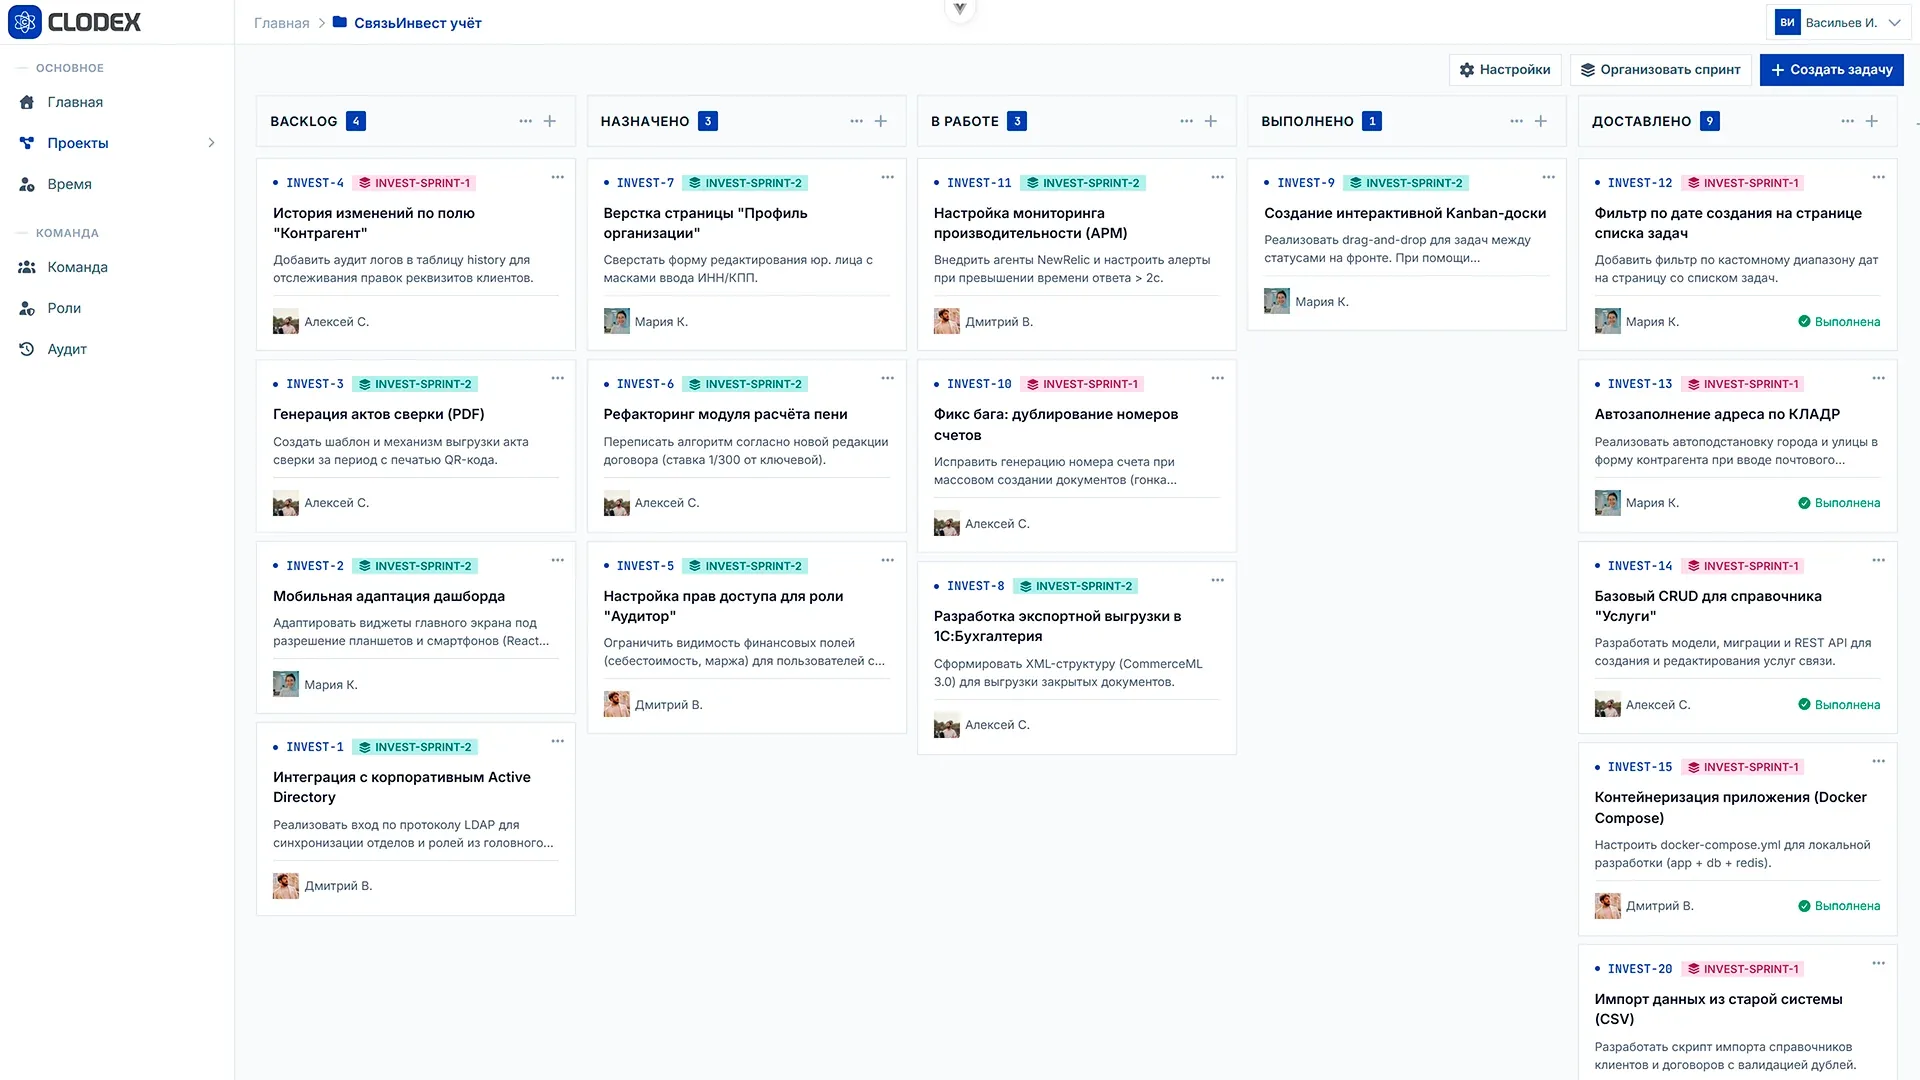
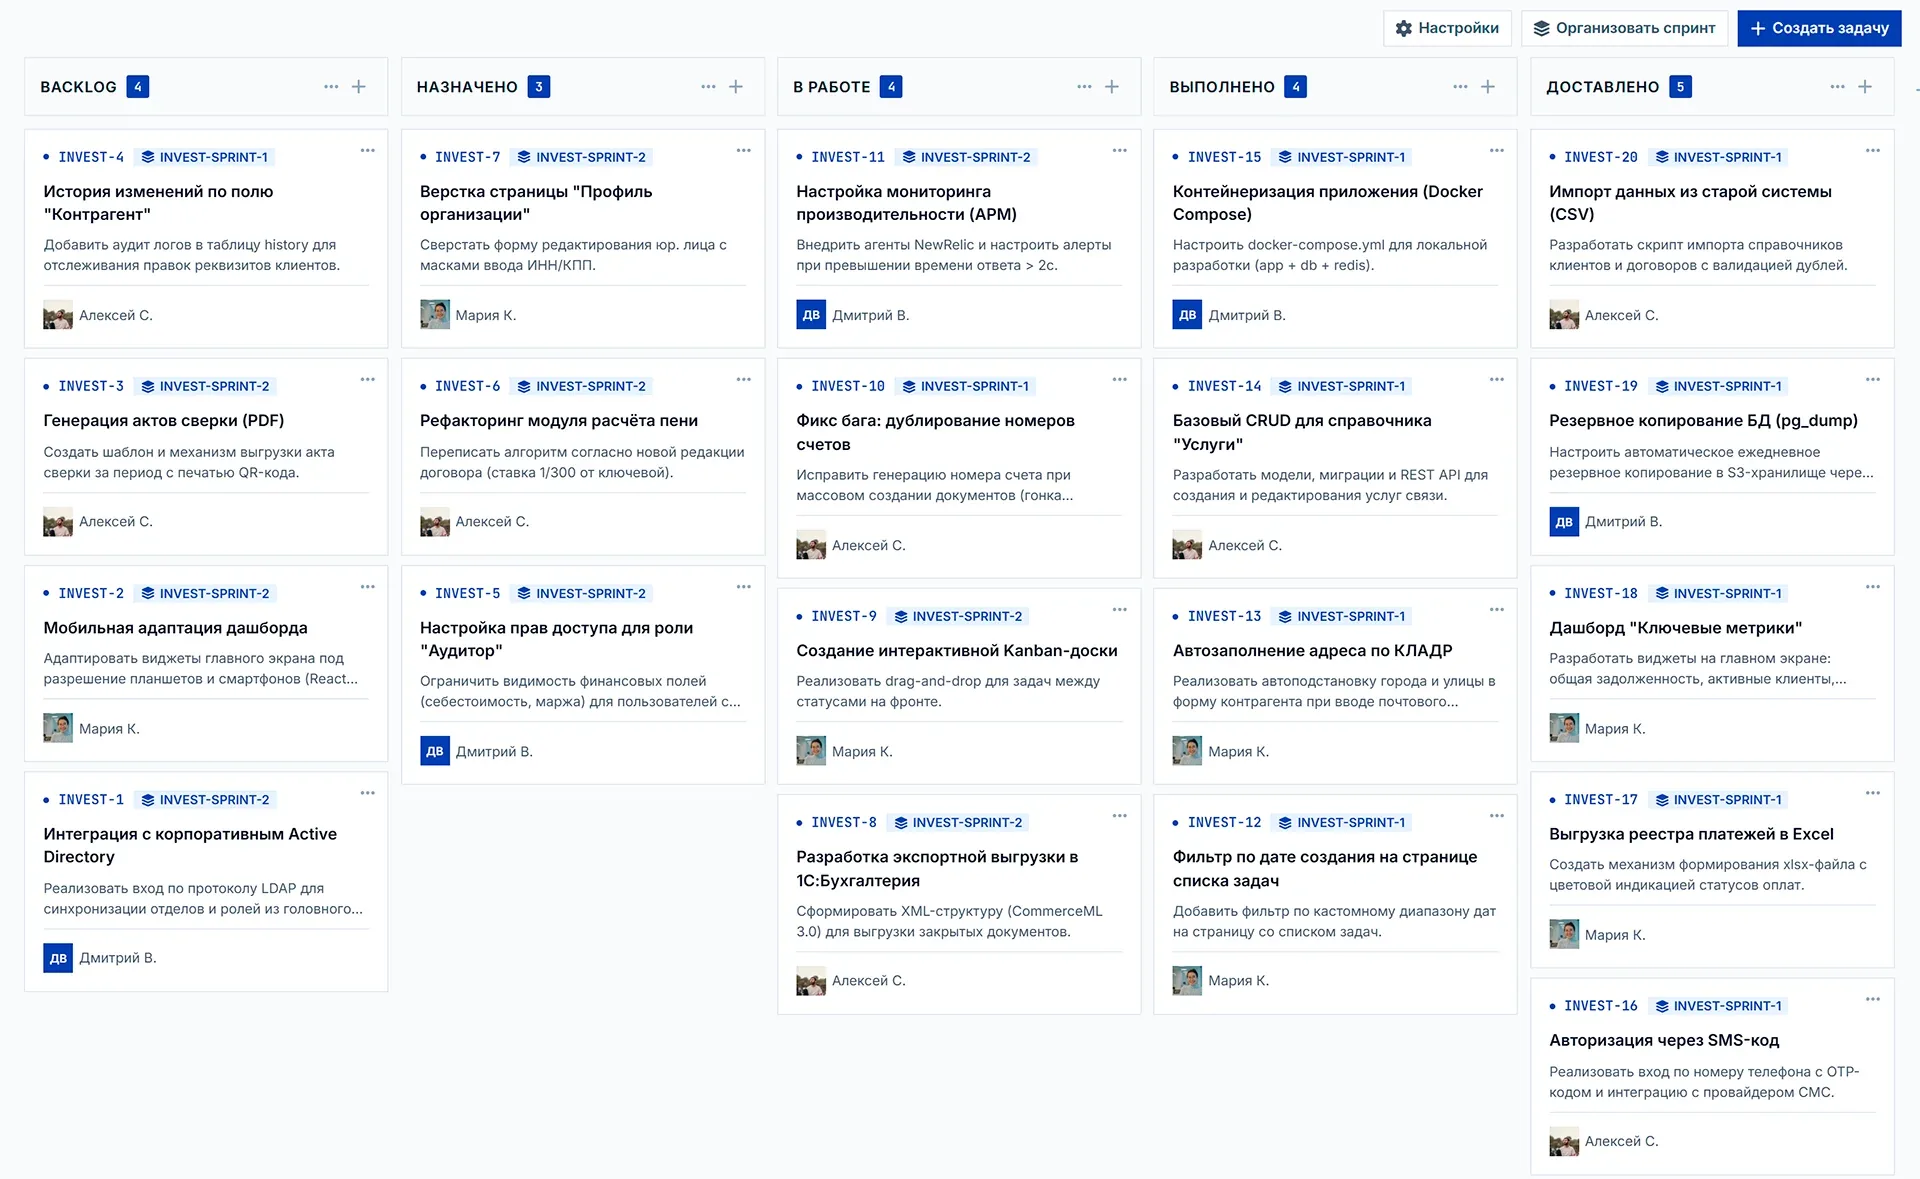
Канбан-доски с этапами под процесс конкретной команды, перетаскивание задач между колонками, теги, вложения и обсуждения прямо в карточке задачи. Файлы хранятся в облачном хранилище и выдаются по защищённым временным ссылкам.
3. Спринты и учёт времени
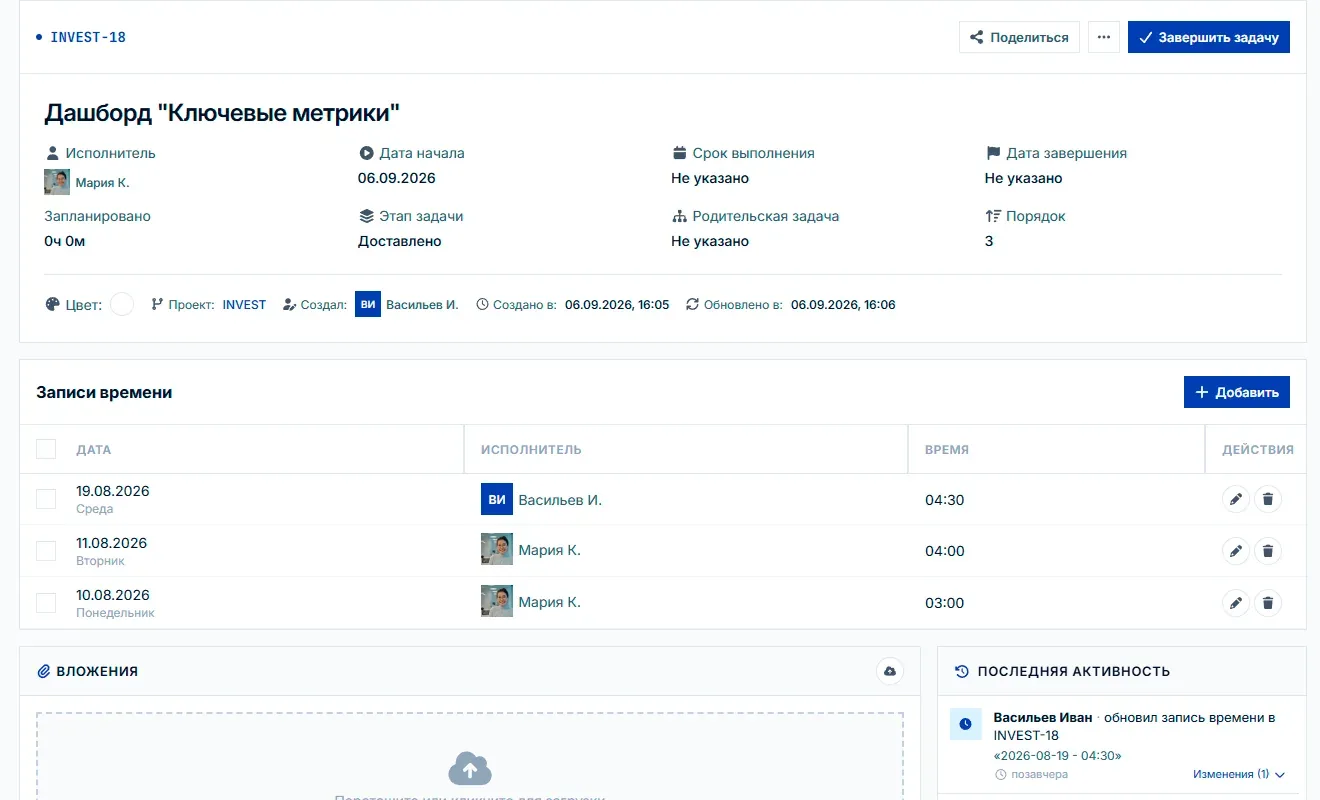
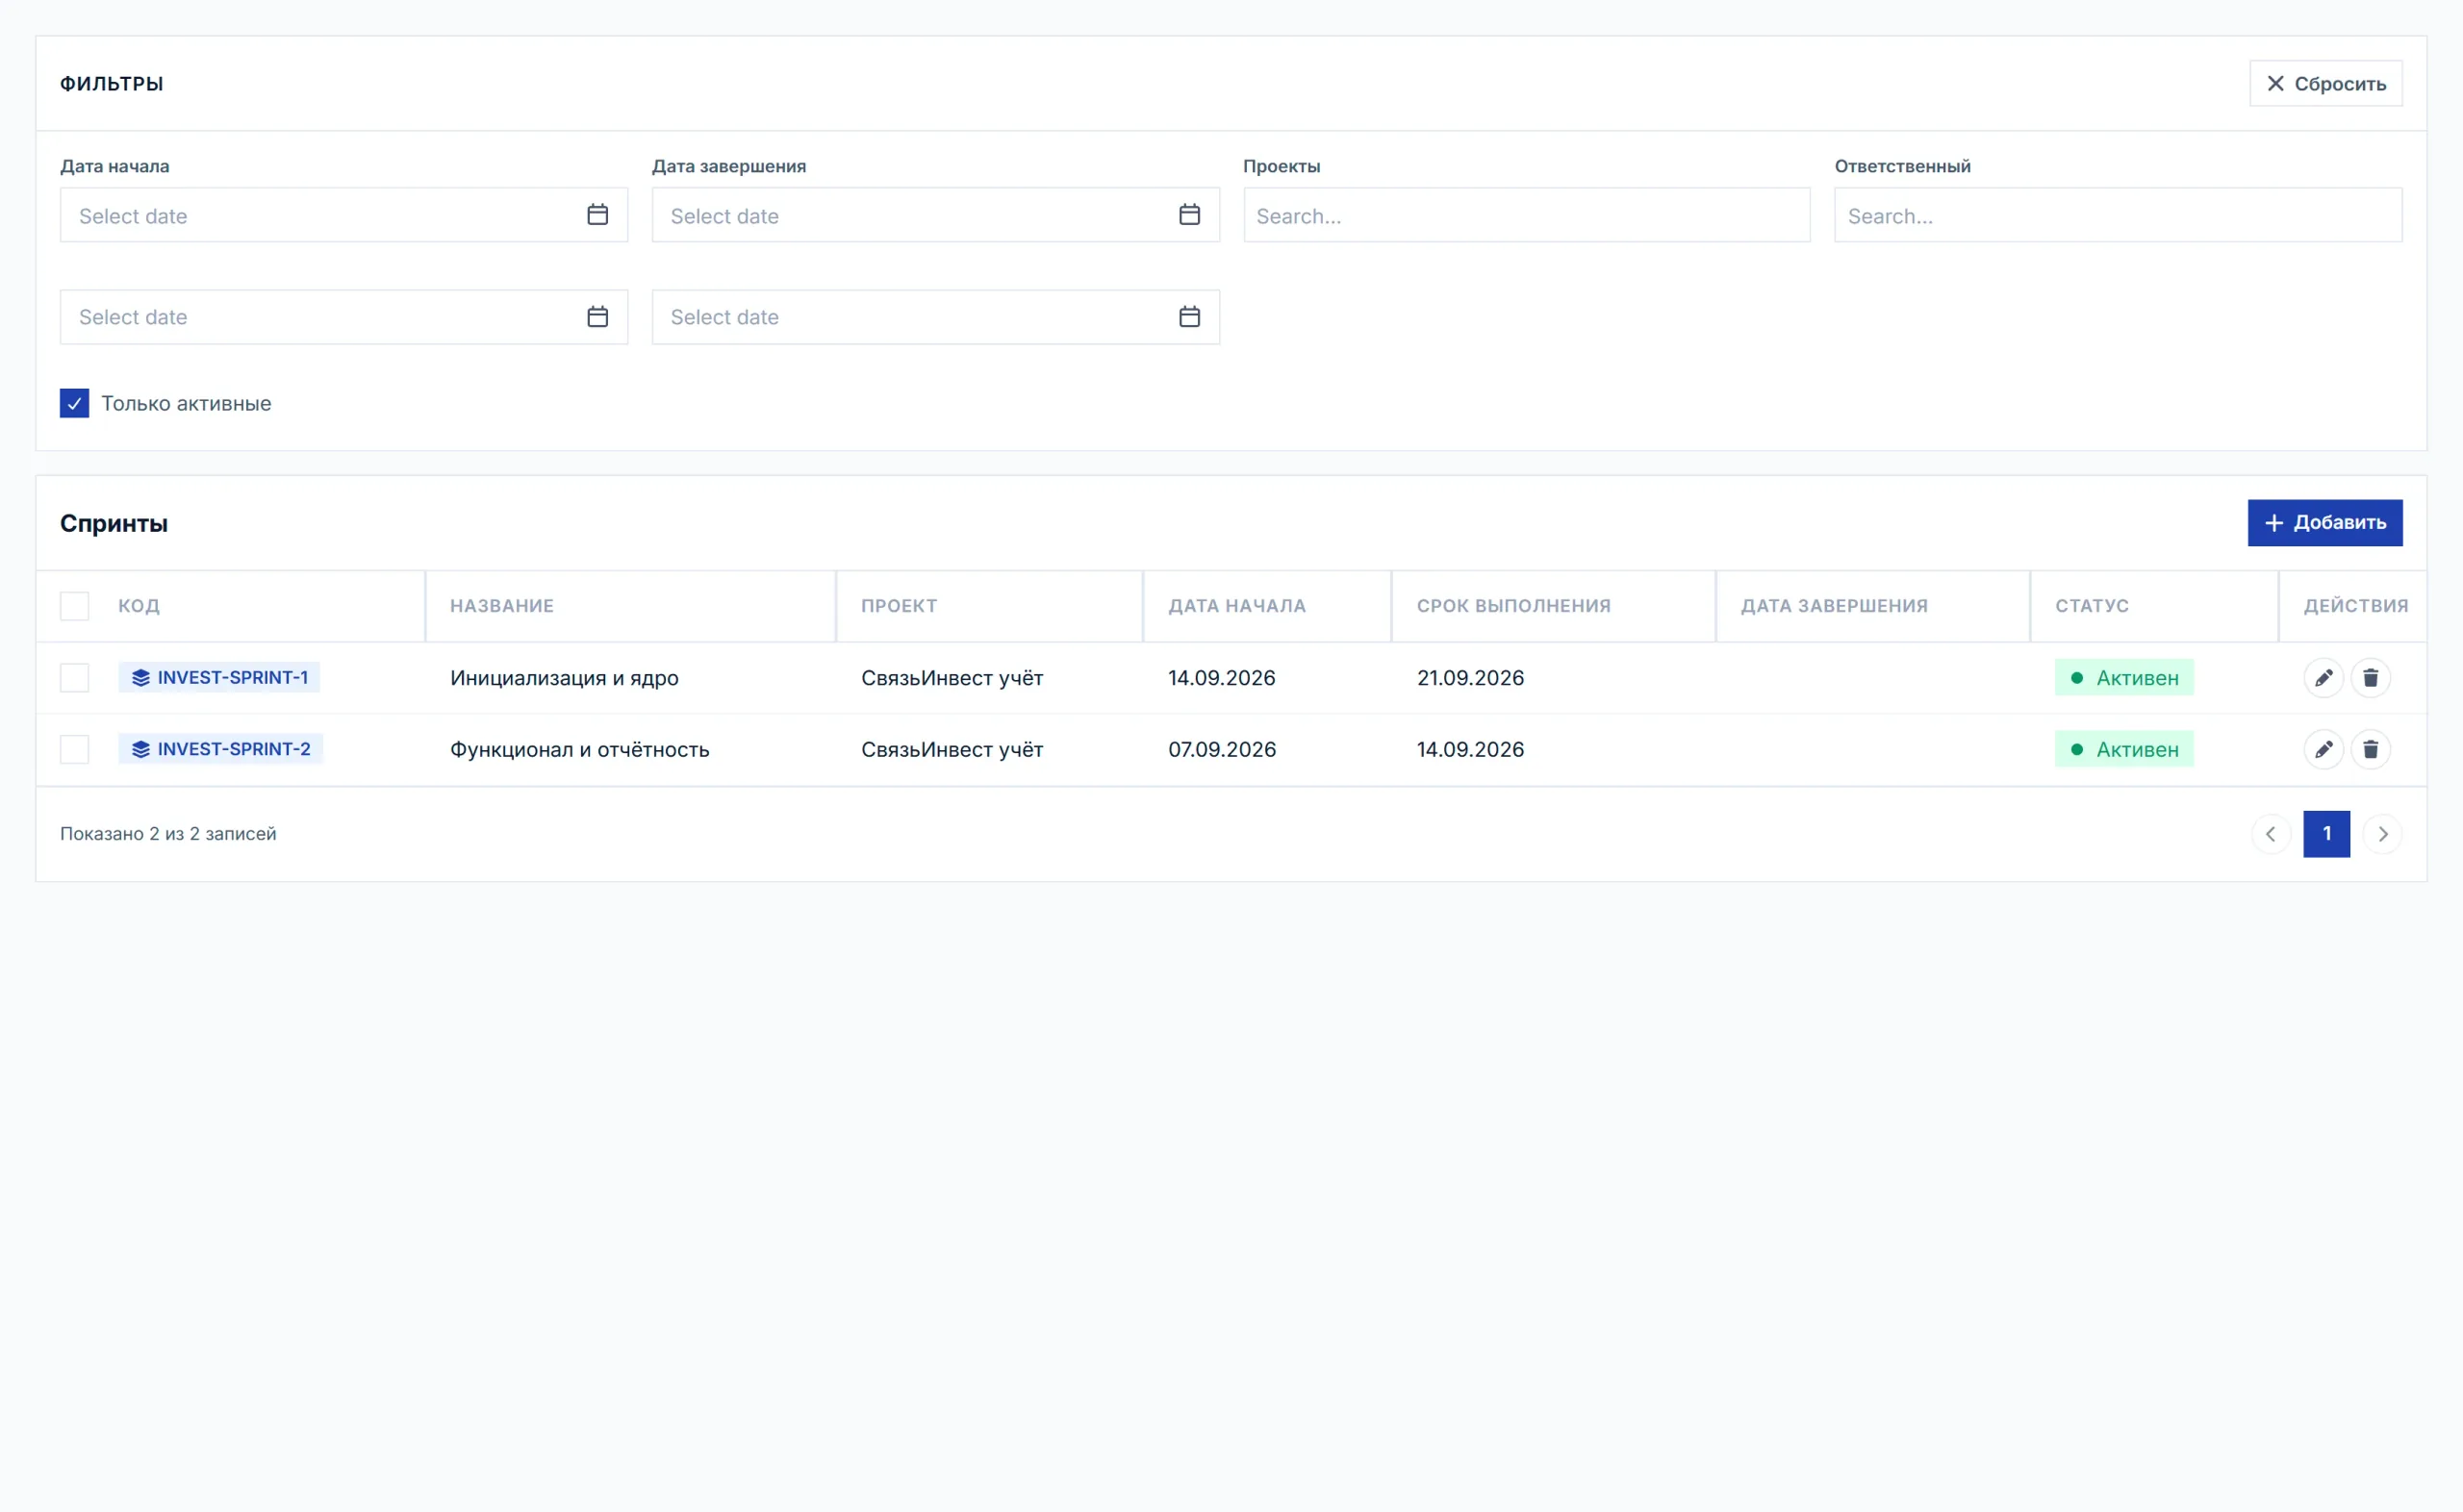
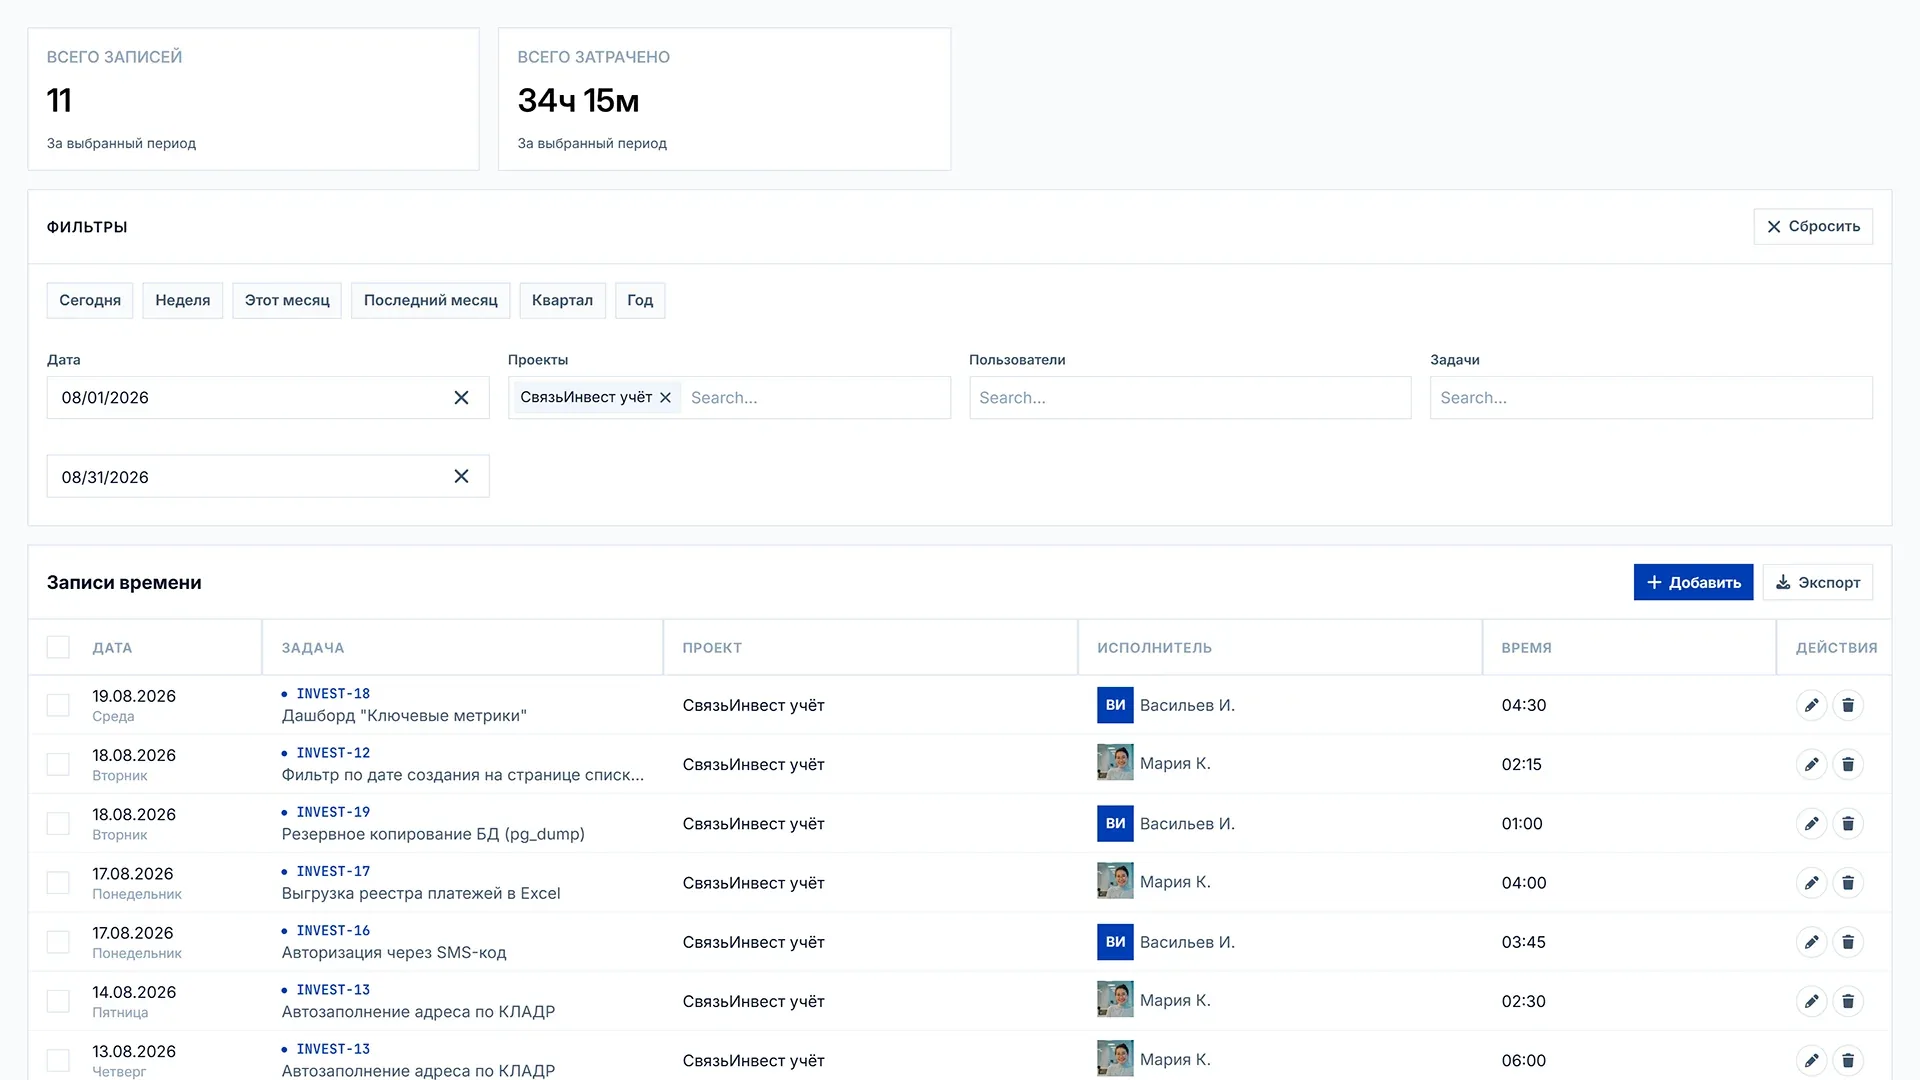
Работу можно разбивать на итерации со сроками и составом задач и наблюдать за прогрессом без ручных отчётов. Учёт времени встроен прямо в задачи: сотрудники списывают часы, а руководители смотрят сводки по людям и спринтам и планируют на основе фактических данных.
4. Автоматизация без кода
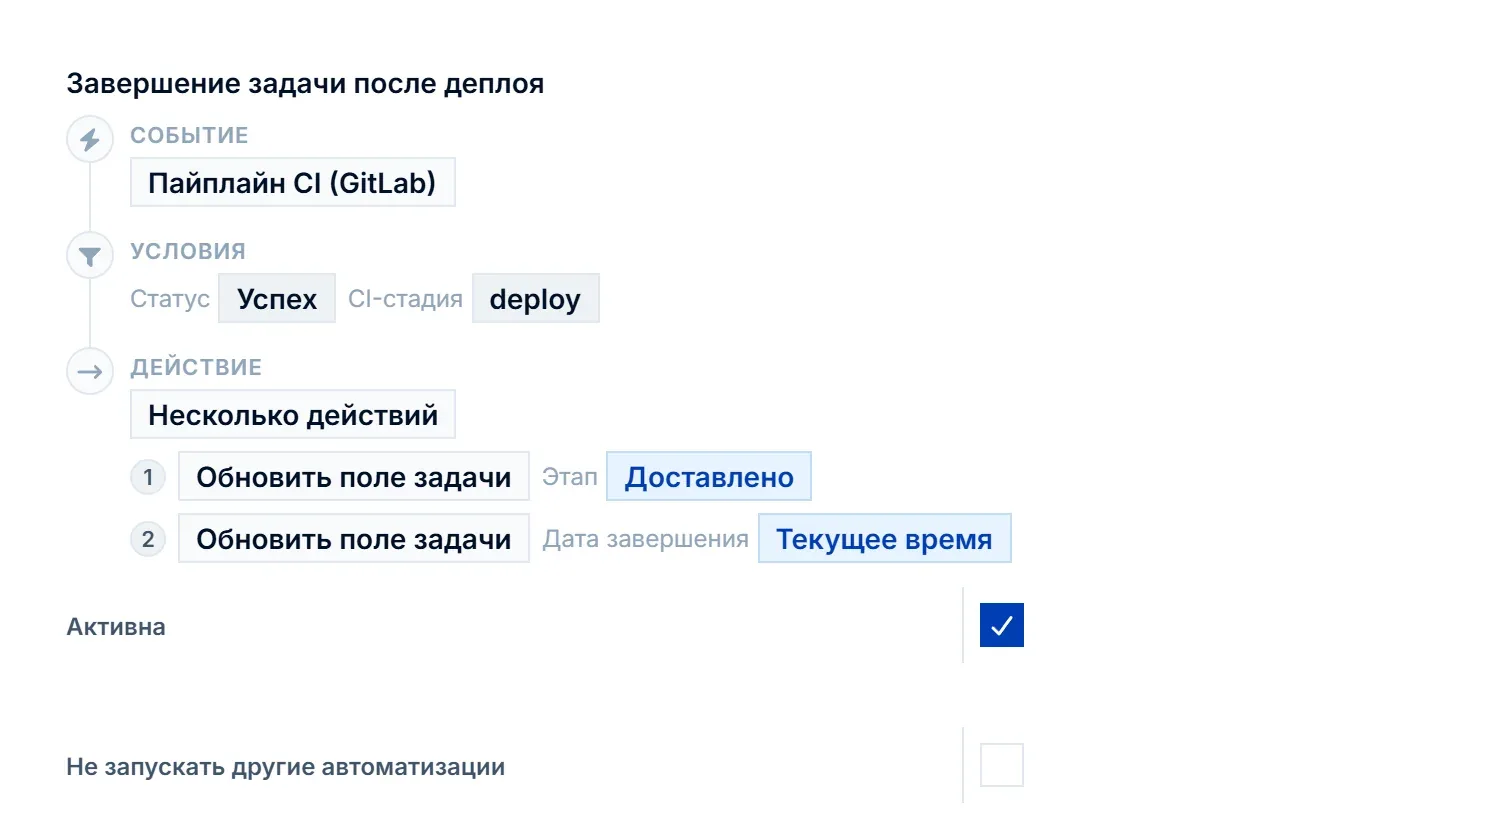
Конструктор правил по схеме «событие → условие → действие». Правило реагирует на создание, изменение или удаление записей и на внешние вебхуки GitLab, проверяет условия с логикой «И/ИЛИ» и выполняет цепочку шагов: переносит задачу на другой этап, обновляет поля, создаёт связанные записи.
Правило можно привязать к конкретному проекту или этапу, а результат каждого запуска сохраняется в истории — видно, что и почему сработало.
5. Безопасность и контроль доступа
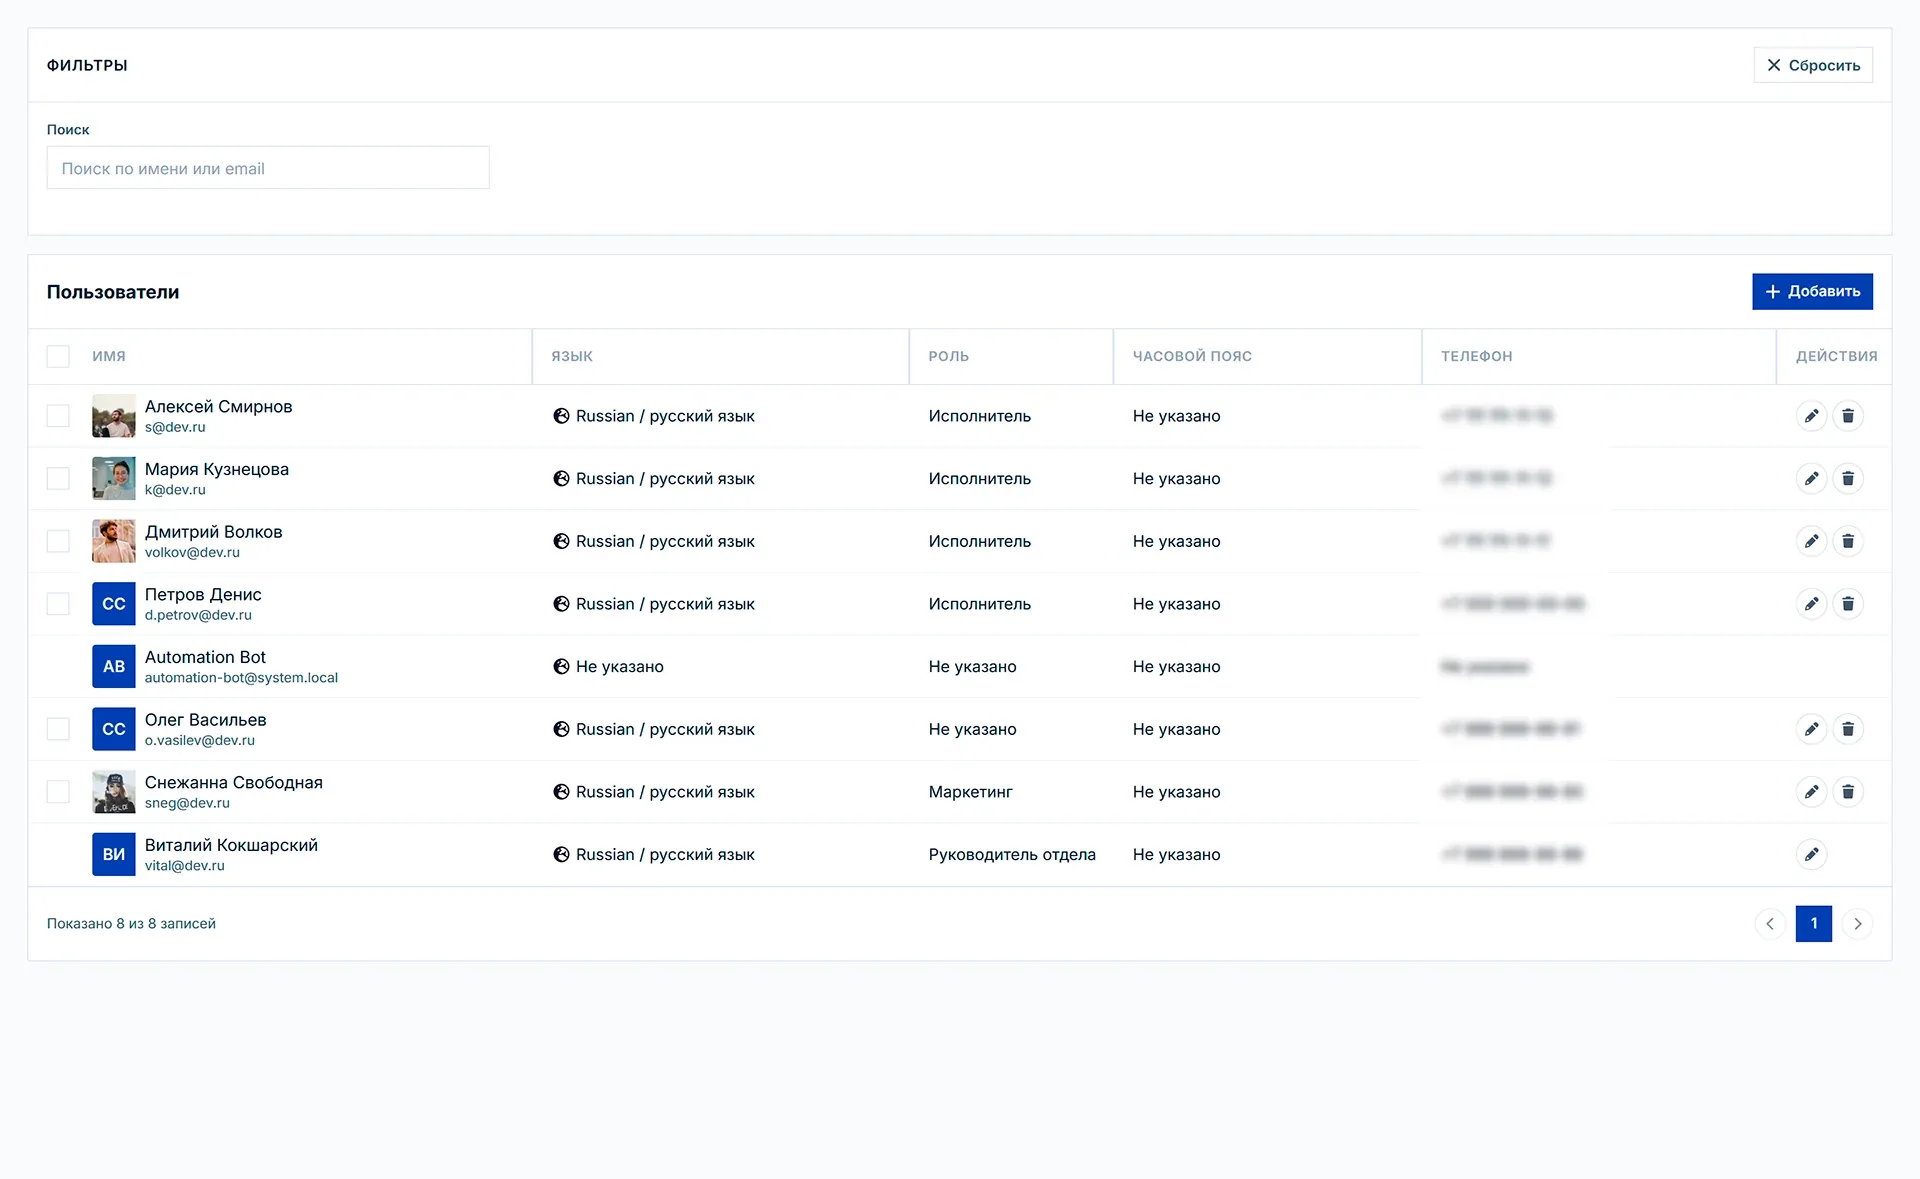
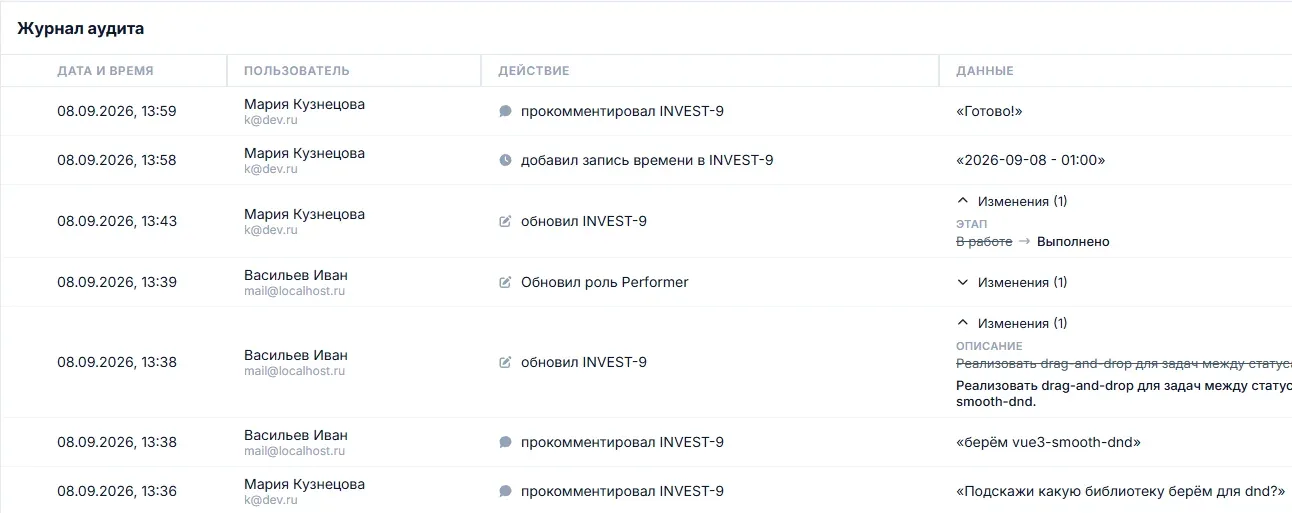
Гибкая ролевая модель: администратор создаёт роли, назначает права на действия и управляет участниками на уровне проектов. Все значимые изменения — от комментария до смены этапа задачи — фиксируются в журнале аудита с указанием автора и старого и нового значения. Вход защищён двухфакторной аутентификацией.
6. Надёжность «под капотом»
То, чего пользователь не видит, но на чём держится стабильная работа сервиса:
Данные непрерывно копируются на реплику PostgreSQL: запросы на чтение уходят на неё и разгружают основную базу, а копия данных всегда наготове.
События сохраняются в одной транзакции с изменениями данных и доставляются через Kafka — ни одно срабатывание автоматизации не теряется.
Очистка неиспользуемых файлов, ретеншн истории и обслуживание данных выполняются по расписанию для всех пространств.
Сервисы работают в Kubernetes: нагрузка распределяется между репликами, а сбой одного экземпляра не останавливает работу.